
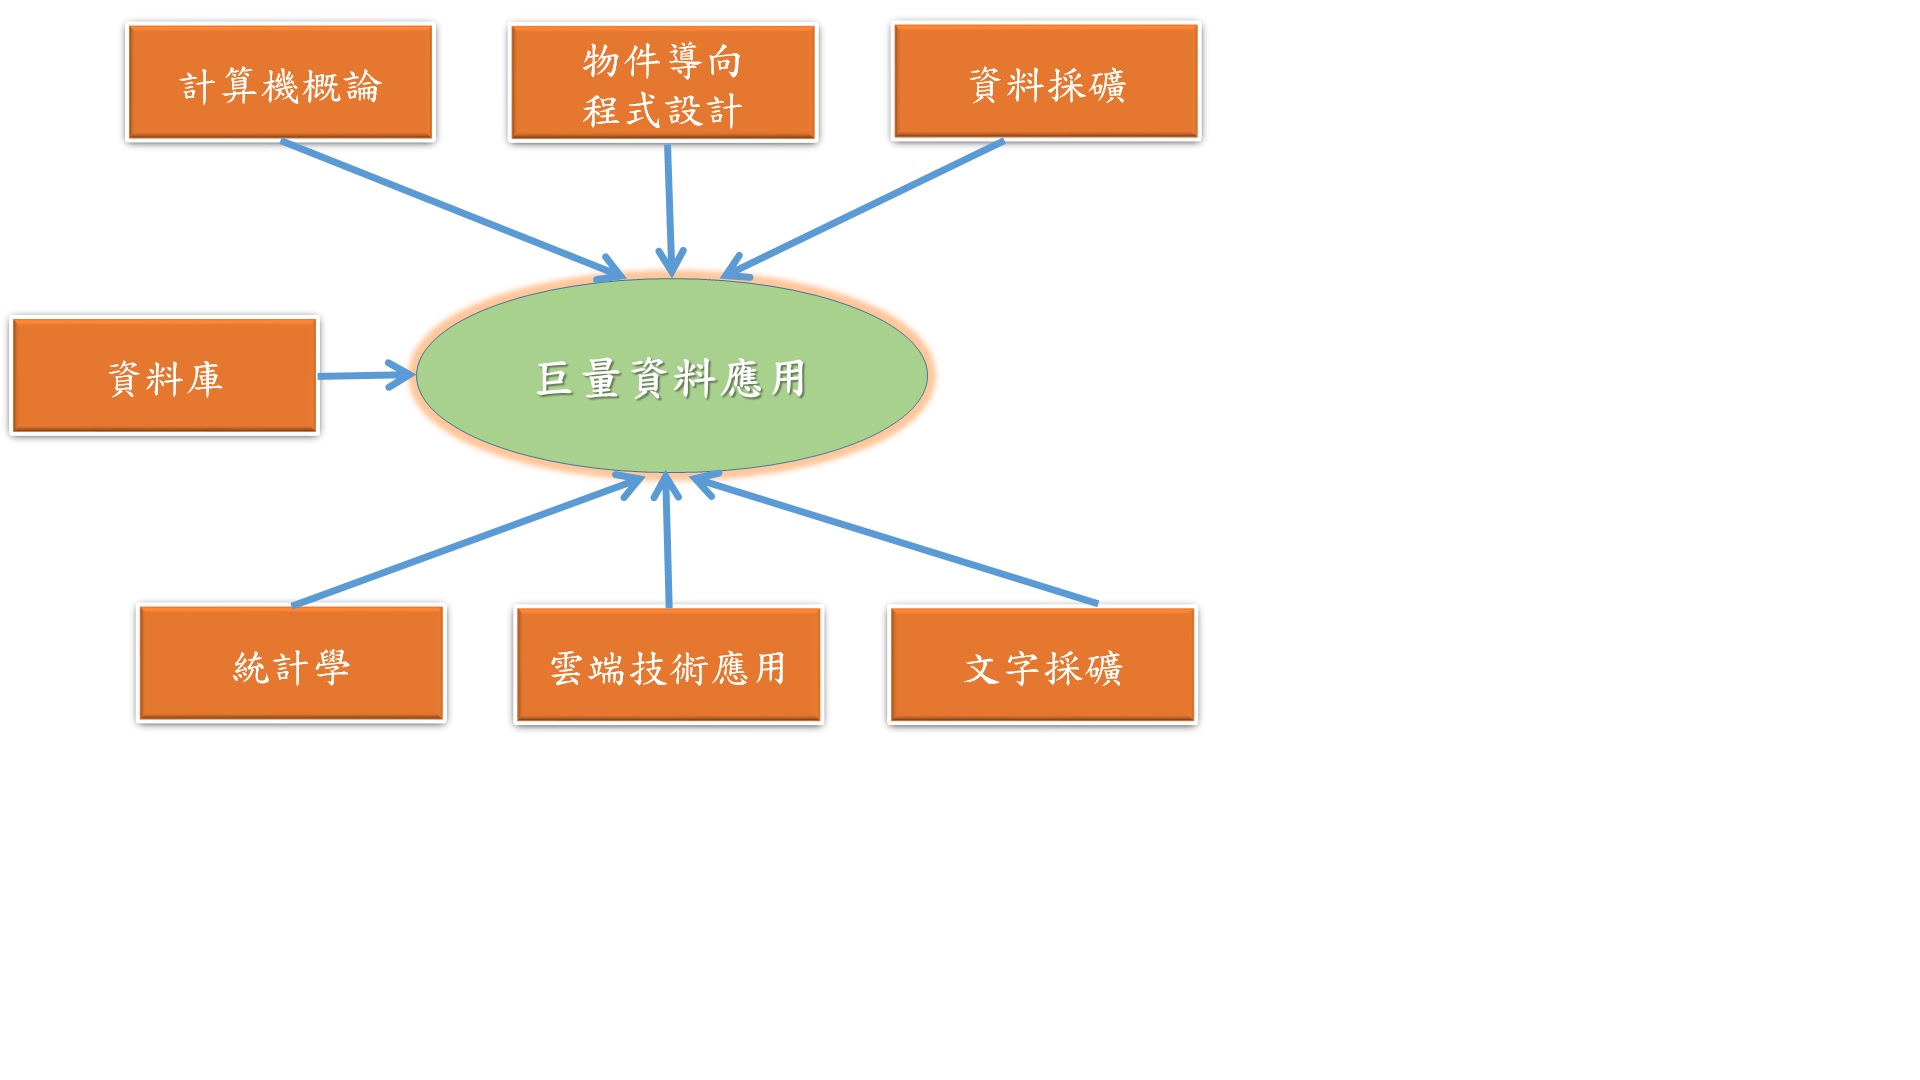
本課程主要以政府公開資料作為學生們上機實作的資料來源。課程內容包括:
1. 如何透過網路爬蟲技術來獲取網站資料。
2. 如何對下載的巨量資料進行清洗工作。
3. 認識巨量資料的4V特性,並藉以了解巨量資料如何處理。
4. 如何安裝SPARK與Hadoop。
5. 如何導入SQL (MySQL)與 No SQL(MongoDB)於巨量資料的儲存。
6. 如何撰寫程式來處理與過濾所要的資料。
7. 撰寫SPSS 所嵌入的Python 2.7.X版程式碼,以進行統計分析。
8. Regular Expression對巨量資料的萃取與量化分析。
9. 上機實作文字採礦和資料採礦。
1. 如何透過網路爬蟲技術來獲取網站資料。
2. 如何對下載的巨量資料進行清洗工作。
3. 認識巨量資料的4V特性,並藉以了解巨量資料如何處理。
4. 如何安裝SPARK與Hadoop。
5. 如何導入SQL (MySQL)與 No SQL(MongoDB)於巨量資料的儲存。
6. 如何撰寫程式來處理與過濾所要的資料。
7. 撰寫SPSS 所嵌入的Python 2.7.X版程式碼,以進行統計分析。
8. Regular Expression對巨量資料的萃取與量化分析。
9. 上機實作文字採礦和資料採礦。
- 教師: 吳 國清